VPS知识分享站
先说结论:PostgreSQL 是进程模型,每个连接一个进程,比 MySQL 更吃内存和连接数。选配置先看连接数和数据热区,再看 CPU;2 核 4G 能跑小站,4 核 8G 适合中型业务,连接数一多就要上连接池,否则加内存也扛不住。
三笔账先算清:
- 连接数:每个连接占内存,还带来进程切换开销
- 热数据:shared_buffers 能缓存多少,决定随机读多少
- 写入量:WAL、autovacuum、备份都会吃 IO
内存怎么分
shared_buffers 通常给物理内存的 25%,work_mem 按并发排序/哈希算,别设太大,否则一个复杂查询就能把内存吃光。剩余留给系统、连接和 page cache。
# 4G 内存示例
shared_buffers = 1GB
work_mem = 8MB
maintenance_work_mem = 256MB
effective_cache_size = 3GB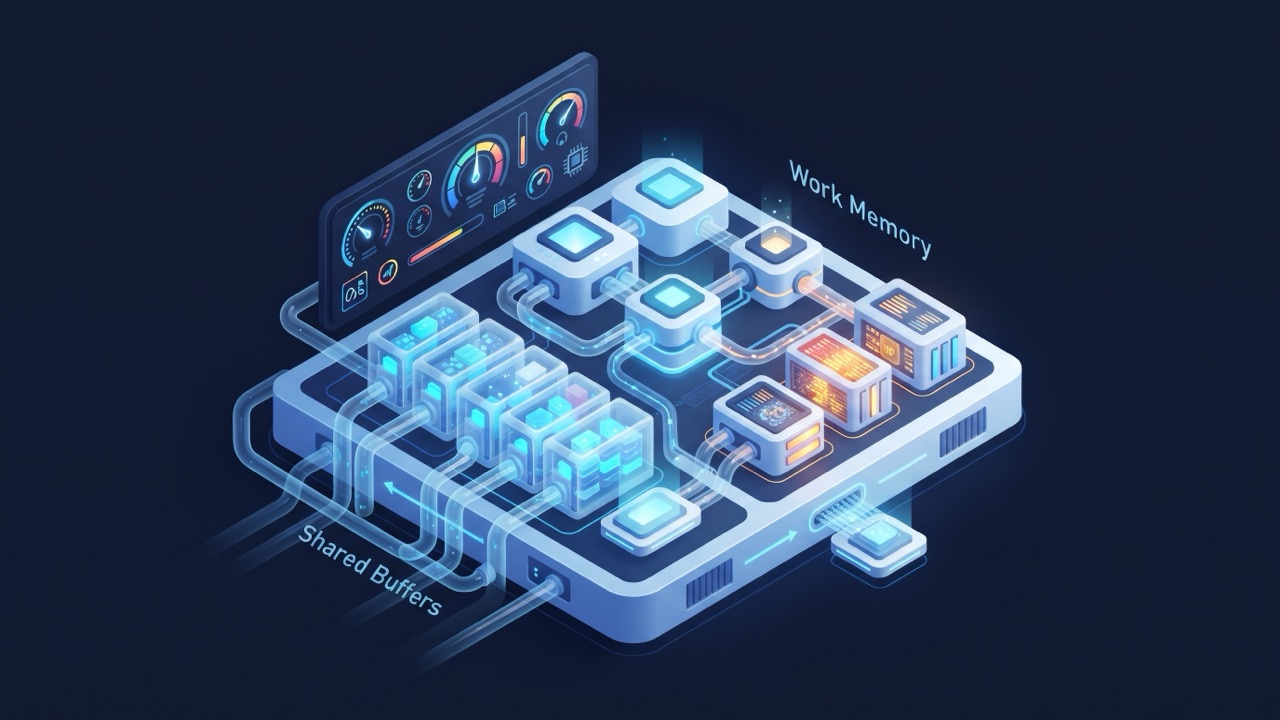
连接和连接池
PostgreSQL 默认 max_connections=100,但 100 个活跃连接已经很多。应用侧用 PgBouncer 或连接池,把连接数压到数据库能处理的量;数据库侧按内存设上限,别靠加 max_connections 硬扛。
磁盘和 IO
PG 的随机读写、WAL 顺序写、autovacuum 都会打盘。用本地 SSD 或高 IOPS 云盘,WAL 和数据盘尽量分开;磁盘满了 PG 会停写,甚至进入只读保护。
配置示例
max_connections = 100
shared_buffers = 1GB
work_mem = 8MB
maintenance_work_mem = 256MB
wal_level = replica
max_wal_size = 2GB
checkpoint_timeout = 15min
autovacuum = on
wal_level=replica 是主从复制的基础;max_wal_size 太小会导致频繁 checkpoint,太大则恢复慢,按写入量调。
备份怎么做
- 逻辑备份:
pg_dump/pg_dumpall,适合小库和迁移 - 物理备份:
pg_basebackup,适合大库和快速恢复 - WAL 归档:按时间点恢复(PITR)
- 备份放站外,定期做恢复演练
pg_dump -Fc -U postgres appdb > /backup/appdb.dump
pg_basebackup -D /backup/base -Ft -z -P -U replicator
主从和复制
流复制做主从,从库可以接只读查询和备份。注意复制延迟:刚写完立刻读从库可能读不到。切换要确认新主数据最新,避免丢事务。
调优看什么
- 慢查询:
pg_stat_statements按总耗时排序 - 索引:缺失索引、无用索引、膨胀
- autovacuum:死元组多、表膨胀
- 连接:活跃连接、等待事件、锁
- 缓存命中:
pg_stat_database的 blks_hit 比例
监控指标
连接数、QPS、慢查询、缓存命中率、复制延迟、磁盘使用率、checkpoint 次数。命中率长期低于 95%,说明 shared_buffers 不够或查询太散。
PgBouncer 怎么用
PgBouncer 支持 session、transaction、statement 三种模式。Web 应用多用 transaction 模式,连接复用率高;但要注意事务级特性、prepared statement 和会话变量的兼容性。先小流量验证,再全量切。
autovacuum 和表膨胀
频繁更新/删除的表会产生死元组,autovacuum 负责回收。表膨胀会让查询变慢、磁盘涨。看 pg_stat_user_tables 的 n_dead_tup,必要时手动 VACUUM 或调 autovacuum 参数。
备份恢复演练
备份不演练等于没有。每季度用备份恢复一台测试库,确认数据完整、版本兼容、恢复时间可接受。PITR 要验证 WAL 归档是否连续,别到恢复时才发现缺文件。
慢查询怎么看
开 pg_stat_statements,按总耗时和平均耗时排序;再看执行计划,确认有没有全表扫描、缺索引、错误的连接顺序。优化 SQL 比加内存更有效。
主从切换注意什么
切换前确认从库复制延迟为 0,切完把旧主降为从库或隔离,避免双写。应用连接串要能快速指向新主,切换脚本要幂等。
没有自动切换方案时,至少准备好手动步骤和回滚方案,别等故障时现查文档。
最后,给数据库留 30% 的内存和磁盘余量,按季度复核连接数、缓存命中率和慢查询趋势,别等告警才调整。
配置只是起点,持续观察连接、缓存、复制和慢查询,才能让数据库稳定跑下去,别怕麻烦,长期坚持才能看到效果,也才能避免突发故障,真的很有必要,别省这一步。
常见问题 FAQ
Q1:2 核 4G 能跑 PostgreSQL 吗?
能跑小站,shared_buffers 给 1G 左右,连接数控制在 50 到 100,复杂查询要优化。
Q2:为什么连接数一多就慢?
PG 每个连接一个进程,连接多了上下文切换和内存开销都上来。用连接池,别直接加 max_connections。
Q3:pg_dump 和 pg_basebackup 怎么选?
小库、单表恢复用 pg_dump;大库、整库快速恢复用 pg_basebackup,再配合 WAL 做 PITR。
Q4:autovacuum 要不要开?
必须开。它可以回收死元组、更新统计信息;不开会导致表膨胀和查询变慢。
Q5:云数据库和自建怎么选?
不想运维、要自动备份和主从,选云数据库;要自定义参数、控制成本,自建更灵活。
总结
PostgreSQL 选配置,先算连接数和热数据,shared_buffers 给 25%,连接池压连接数,磁盘选高 IOPS。备份用 pg_dump + basebackup + WAL,主从注意延迟。
需要一台独立数据库机器做测试或从库,可以按小时开一台萤光云香港 CN2 VPS,先跑真实数据。