VPS知识分享站
先说结论:load average 高但 CPU 不高,通常不是“算不过来”,而是“等不过来”。常见原因是磁盘 IO 慢、进程卡在不可中断状态(D)、连接队列堆积、内存回收/swap,或者锁竞争。先看 wa、r 队列和 D 状态进程,再决定加 CPU 还是换盘。
先理解 load average:它统计的是“运行中 + 不可中断”的进程数,不直接等于 CPU 使用率。一个进程卡在磁盘 IO 上,也会推高 load,但 CPU 可能很闲。
先看三个数
uptime
vmstat 1 5
top- r:运行队列,持续大于核数说明 CPU 或调度有压力
- b:不可中断进程,通常卡在 IO
- wa:IO 等待,高说明磁盘/网络存储慢
load 高、r 不高、b 高、wa 高,基本就是 IO 问题;load 高、r 高、us/sy 高,才是 CPU 问题。
找 D 状态进程
ps -eo pid,stat,wchan:30,cmd | awk '$2 ~ /D/'
cat /proc/<pid>/stack 2>/dev/null
D 状态进程不响应信号,kill -9 也没用,只能等 IO 完成或重启机器。看它卡在哪个设备、哪个文件系统,常见是 NFS、云盘、坏盘或磁盘队列满。
看磁盘 IO
iostat -x 1 5
iotop -o
pidstat -d 1 5
重点看 await、%util、r_await、w_await。await 高、util 满,说明盘忙不过来;如果 util 不高但 await 高,可能是网络存储或虚拟化层的问题。
看内存和 swap
free -m
vmstat 1 5
# si/so 持续非 0 说明在换页
内存不足时会触发回收和 swap,进程频繁换入换出,load 升高但 CPU 不高。看 available、si/so、OOM 日志;数据库和 Redis 尤其怕 swap。
看连接队列
ss -lnt
ss -s
netstat -s | grep -i -E 'listen|overflow|retrans'
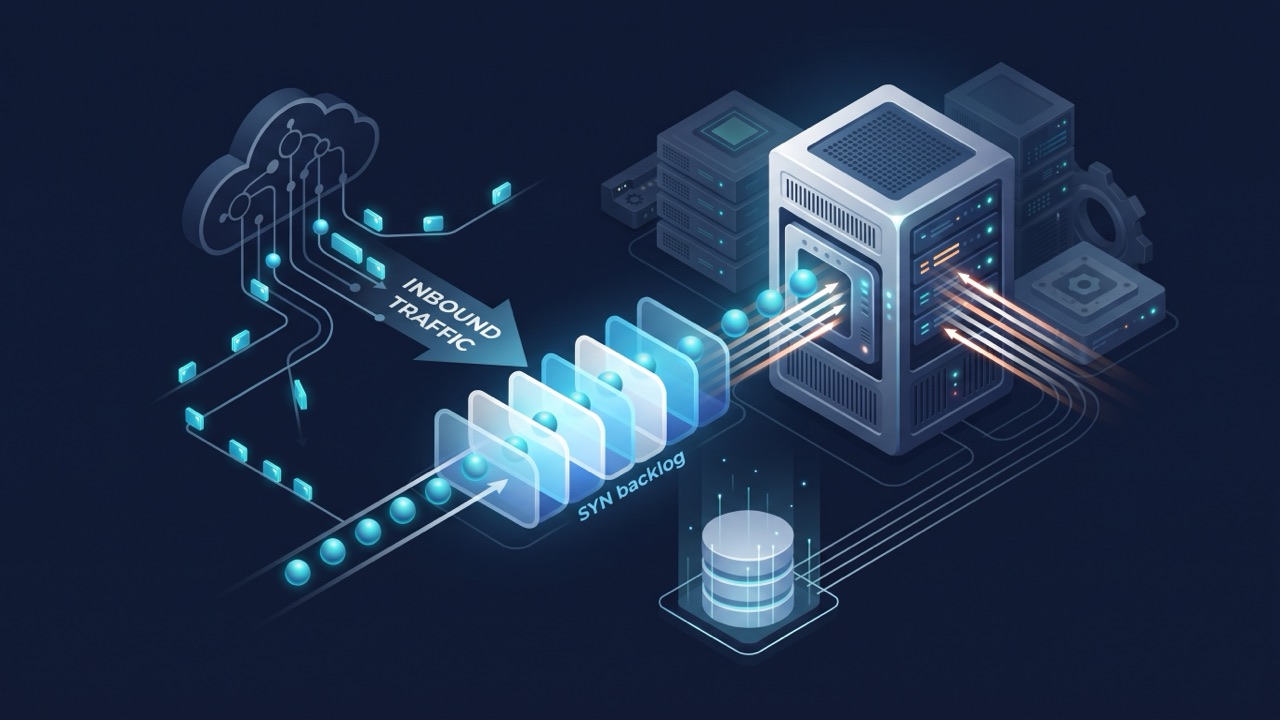
SYN 队列或 accept 队列满了,新连接会排队或丢弃,应用看起来“卡”,但 CPU 不高。看 Send-Q、Recv-Q、ListenOverflows,调 backlog 或加应用并发。
看锁和数据库
应用线程等锁、数据库等行锁/表锁,也会让请求堆积。Java 看线程栈,PHP 看 slow log,MySQL 看 SHOW ENGINE INNODB STATUS 和 performance_schema。锁等待不占 CPU,但会把队列拉长。
排查顺序
- uptime/vmstat 看 r、b、wa
- ps 找 D 状态进程
- iostat/iotop 定位磁盘
- free 看内存和 swap
- ss 看连接队列
- 应用/数据库看锁和慢查询
- 最后才考虑加 CPU
应急处理
- 限流、降级非核心接口
- 把备份、压缩、日志归档挪走
- 重启卡死的 worker(确认不是数据库连接)
- 临时加内存/换高 IOPS 盘
- 保留现场:vmstat、iostat、D 状态进程、连接队列
怎么预防
- 监控 load、r、b、wa、iowait、swap、连接队列
- 磁盘留 20% 余量,定期测 IOPS
- 数据库慢查询和锁等待告警
- 应用连接池和超时设置合理
- 备份/日志错峰
load 和 CPU 的区别
CPU 使用率是“CPU 忙不忙”,load 是“有多少任务在跑或在等”。CPU 100% 但 load 不高,可能是单线程打满;load 很高但 CPU 很闲,通常是在等 IO、等锁、等连接。
常见场景
数据库全表扫描、备份压缩、NFS 卡顿、云盘限速、内存不足换页、连接池打满、日志同步刷盘,都会让 load 升高但 CPU 不高。先对照最近变更和任务排期。
排查工具
vmstat 看 r/b/wa,iostat 看 await/util,iotop 看进程,ss 看队列,pidstat 看 CPU/IO,dmesg 看 OOM 和磁盘错误。工具不在多,关键是对照时间点。
什么时候加机器
只有 CPU 真的成为瓶颈(r 高、us/sy 高)才加 CPU;IO 问题换高 IOPS 盘,内存问题加内存,连接问题调应用和 backlog。加错方向,钱花了问题还在。
网络存储和 NFS
NFS、CIFS 等网络存储在抖动时会让进程卡在 D 状态,load 飙升但 CPU 很闲。检查挂载参数、网络延迟和服务端负载,必要时改本地盘。
云盘突发额度
部分云盘有突发 IOPS,额度用完就掉速,表现为白天正常、晚上卡。看云监控的 IOPS 和吞吐曲线,确认是否触发限速。
最后,load 要看趋势和持续时间:偶尔冲高不用慌,持续高位且业务受影响才需要处理。把 1/5/15 分钟曲线和业务指标放一起看,避免误判。
每次排查记录时间、现象、命令输出和处理结果,下次遇到类似问题能直接对照,不用从零开始。
排查顺序比工具更重要,先定位方向再深入。
方向对了,工具才有意义,这一点真的很重要啊哈。
常见问题 FAQ
Q1:load 高就是 CPU 不够吗?
不是。load 包含不可中断进程,IO 等待、swap、连接队列都会推高 load,但 CPU 可能很闲。
Q2:D 状态进程能 kill 吗?
普通 kill 和 kill -9 通常无效,只能等 IO 完成、修复存储或重启。先查它卡在哪个设备。
Q3:wa 高但 util 不高,怎么回事?
可能是网络存储、虚拟化层或云盘限速。看云监控的 IOPS/吞吐曲线,和宿主机 iostat 对照。
Q4:连接队列满了怎么办?
调大 backlog、加应用 worker、优化慢请求;同时看是否有攻击或爬虫占着连接。
Q5:加 CPU 能解决吗?
只有 r 高、us/sy 高时才有效。IO、内存、锁导致的 load 高,加 CPU 没用。
总结
load 高 CPU 不高,先看 r/b/wa,再找 D 状态进程、磁盘、内存、连接队列和锁。大多数情况是“等 IO/等锁/等连接”,不是算力不够。按顺序排查,别盲目升配。
需要一台 IO 更稳的机器做对照,可以按小时开一台萤光云香港 CN2 VPS,用 fio 和 iostat 先测一轮。