VPS知识分享站
先说结论:云服务器监控的最小可用组合是 node_exporter + Prometheus + Grafana + Alertmanager。node_exporter 采集,Prometheus 存储和告警,Grafana 展示,Alertmanager 负责通知和分组。小团队一台 2 核 4G 就能跑,但监控数据会占磁盘,保留时间要设上限。
先看架构:
- node_exporter:跑在每台被监控机器上,暴露 CPU、内存、磁盘、网络指标
- Prometheus:定时拉取指标,存时间序列,按规则告警
- Grafana:查询 Prometheus,画面板和图表
- Alertmanager:接收告警,去重、分组、静默、路由到邮件/钉钉/飞书
部署方式
可以用 Docker Compose 一次拉起,也可以分开装。监控机建议独立,别和被监控业务抢资源;小规模可以和业务同机,但要限制 Prometheus 内存和保留时间。
services:
  prometheus:
    image: prom/prometheus
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml
      - prom-data:/prometheus
    ports: ["9090:9090"]
  grafana:
    image: grafana/grafana
    volumes: [grafana-data:/var/lib/grafana]
    ports: ["3000:3000"]
  node-exporter:
    image: prom/node-exporter
    ports: ["9100:9100"]
volumes:
  prom-data:
  grafana-data: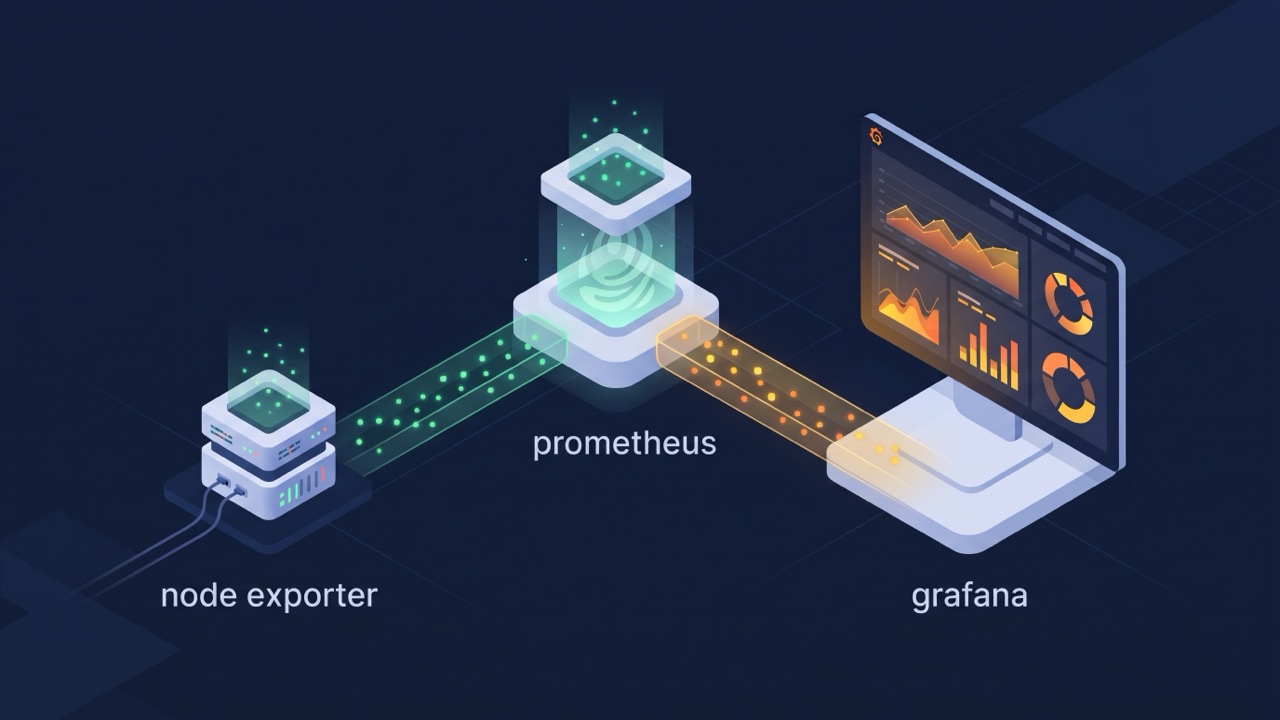
Prometheus 配置
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: node
    static_configs:
      - targets: ['node-exporter:9100']
  - job_name: app
    static_configs:
      - targets: ['app:8080']
被监控机器多时,用文件服务发现或各自跑 node_exporter,Prometheus 统一拉取。跨公网拉取要加 TLS 和鉴权,别把 9090 暴露公网。
看哪些指标
- CPU:使用率、iowait、steal
- 内存:available、swap、OOM
- 磁盘:使用率、inode、await、IOPS
- 网络:带宽、丢包、重传
- 系统:load、文件描述符、进程数
- 应用:QPS、错误率、延迟、队列长度
指标不在多,关键是能对应到业务。CPU 高不一定影响用户,错误率和延迟升高才是。
告警规则
groups:
  - name: server
    rules:
      - alert: HighCPU
        expr: 100 - avg by(instance)(rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100 > 85
        for: 10m
        labels: {severity: warning}
        annotations: {summary: "CPU 持续高于 85%"}
      - alert: DiskFull
        expr: (node_filesystem_avail_bytes / node_filesystem_size_bytes) * 100 < 15
        for: 10m
        labels: {severity: critical}
      - alert: TargetDown
        expr: up == 0
        for: 2m
        labels: {severity: critical}
for 很重要,避免瞬时抖动刷告警;阈值按业务基线调,别照抄。
通知怎么配
Alertmanager 负责分组、抑制、静默和路由。按 severity 分到不同渠道:critical 打电话/钉钉,warning 发群,info 只记录。配置 group_wait、group_interval、repeat_interval,避免半夜被同一告警刷屏。
Grafana 面板
先导入 Node Exporter Full 模板,再按业务加应用面板。面板分三层:总览(红绿灯)、资源(CPU/内存/磁盘/网络)、业务(QPS/错误率/延迟)。每块面板都要能回答问题,不是为了好看。
存储和保留
Prometheus 本地存储按时间保留,默认 15 天,数据量大时磁盘涨得快。设置 --storage.tsdb.retention.time=15d 或容量上限;长期存储接 Thanos/VictoriaMetrics,小团队先别上。
安全
Prometheus、Grafana、node_exporter 都不要直接暴露公网。Grafana 改默认密码、开 HTTPS、限制来源;node_exporter 只让 Prometheus 访问;Alertmanager 的 webhook 也要鉴权。
常见坑
- 监控和被监控业务同机,故障一起挂
- 保留时间太长,磁盘先满
- 告警没有 for,抖动刷屏
- 只监控 CPU,不监控磁盘和证书
- Grafana 默认密码不改,被扫到
- 告警发到没人看的群
常见问题 FAQ
Q1:2 核 4G 能跑 Prometheus + Grafana 吗?
能,监控十几台机器没问题。注意保留时间和磁盘,数据量大了加内存或换远端存储。
Q2:node_exporter 要每台都装吗?
要,它采集主机指标。应用指标用各自的 exporter 或埋点。
Q3:告警发到哪里好?
按团队习惯:钉钉/飞书/企业微信/Slack/邮件。关键是有人响应,别只发到一个没人看的邮箱。
Q4:Prometheus 和 Zabbix 怎么选?
云原生、容器多、指标维度多,选 Prometheus;传统主机、网络设备、要开箱即用,Zabbix 也够。
Q5:监控数据要保留多久?
小团队 15 到 30 天够排障;合规或趋势分析再延长,并做降采样或远端存储。
总结
监控不是装个 Grafana 就完事:采集、存储、告警、通知、面板、保留策略、安全,每一环都要配。先监控核心指标,再逐步加应用和业务指标,别一开始铺太大。
需要一台独立监控机,可以按小时开一台萤光云香港 CN2 VPS,把 Prometheus 和 Grafana 先跑起来。