
 VPS知识分享站
知识库答不准,先别急着换大模型。很多时候是向量库没选对:该过滤的没过滤,该走索引的走了全表扫描,几万条文档就慢得不像话。RAG 的召回质量,一半在切分,一半在向量库。
三种常见选择
| 方案 | 适合 | 代价 |
|---|---|---|
| pgvector | 已有 Postgres、数据量百万级以内 | 索引和调优要懂 Postgres |
| Qdrant | 中等规模、要过滤和混合检索 | 多一个服务要维护 |
| Milvus | 千万级以上、要分布式 | 组件多,运维重 |
小团队从 pgvector 起步最省事;数据量上来再迁 Qdrant;Milvus 不是“更高级”,是“更重”。
pgvector 怎么用
CREATE EXTENSION vector;
CREATE TABLE docs (
  id bigserial PRIMARY KEY,
  content text,
  embedding vector(1024)
);
CREATE INDEX ON docs USING hnsw (embedding vector_cosine_ops);
维度要和 Embedding 模型一致,bge-m3 是 1024 维;索引建 HNSW,别用默认的 IVFFlat 却不调 lists。数据量小的时候全表扫描也能跑,但别拿它当长期方案。
Qdrant 怎么跑
docker run -d --name qdrant \
  -p 6333:6333 -p 6334:6334 \
  -v /data/qdrant:/qdrant/storage \
  qdrant/qdrant
Qdrant 的强项是 payload 过滤:按租户、分类、时间过滤后再检索,比“先搜再筛”准。多租户场景用 tenant 字段做过滤,别一个 collection 混所有客户。
选型看什么
- 数据量:十万级 pgvector 够,千万级再考虑 Milvus
- 过滤条件:多租户、权限、时间范围,Qdrant 更顺手
- 团队栈:已经在 Postgres 上,就别为向量库再学一套
- 运维成本:Milvus 要 etcd、对象存储、多个组件
- 备份恢复:能不能快照、能不能重建索引
美国还是德国
向量库是内存和磁盘密集型,节点选择看用户和数据位置。
- 美国:机型多、内存便宜,适合大索引和批量写入
- 德国:欧盟用户近,数据本地化合规更稳
- 香港/日本:亚洲用户近,适合前台检索
如果知识库含欧盟用户数据,放德国能减少跨境解释成本;如果只是内部文档,美国性价比更高。别把向量库和模型放太远,检索延迟会叠到首 token 上。
备份和重建
向量库的备份分两层:原始文档和向量索引。原始文档必须单独存,索引坏了可以重建;只备份索引,换模型就废了。
# Qdrant 快照
curl -X POST http://127.0.0.1:6333/collections/docs/snapshots
# pgvector 随 Postgres 一起备份
pg_dump -Fc app > app.dump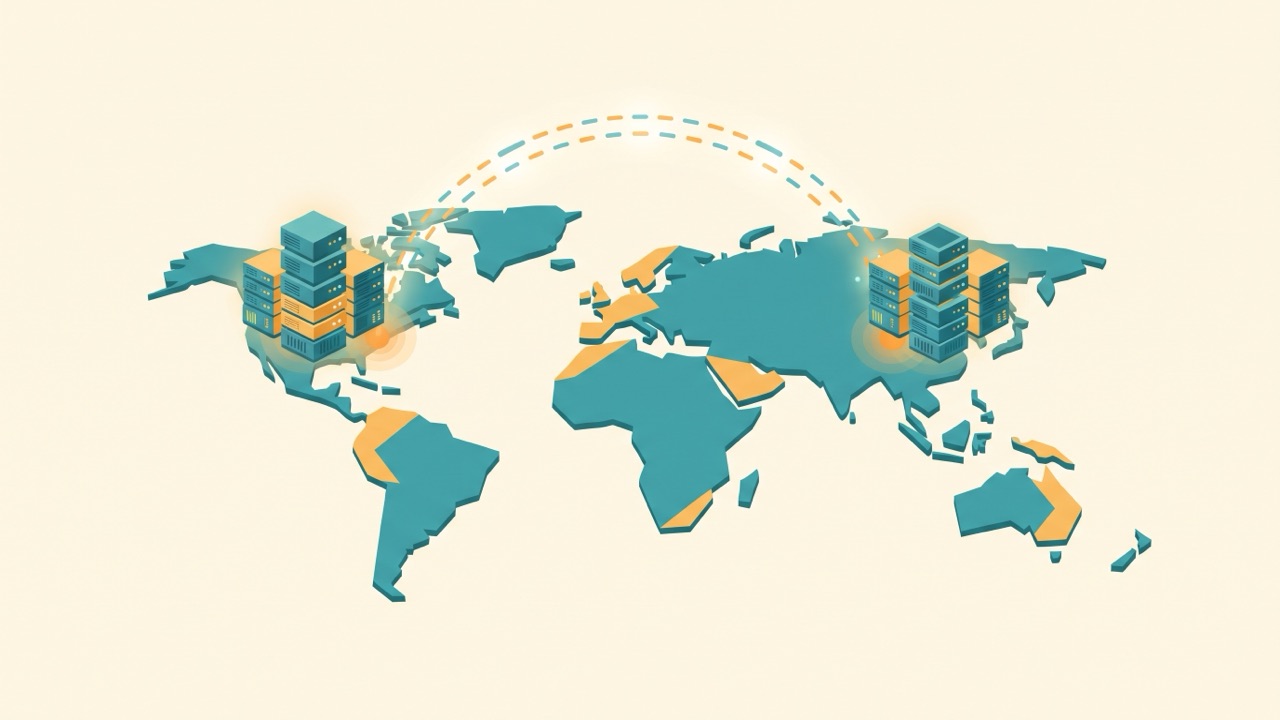
性能调优
- HNSW 的 m、ef_construct 别照抄默认值,按召回和内存调
- 批量写入,别一条一条 insert
- 过滤字段建 payload 索引
- 监控内存、磁盘 IO、查询 P95
- 定期重建索引,删除大量数据后尤其需要
Embedding 怎么选
bge-m3 支持多语言,1024 维;英文可以用更小的模型。维度和向量库要匹配,换模型就要重建索引,别混用。
多租户
多客户场景按 tenant 过滤,别把所有数据塞一个集合;过滤字段建索引,否则先全量搜再筛,慢且不准。
监控
看查询 P95、内存、磁盘 IO、索引大小和召回率;召回率靠人工标注一小批问题,别只看延迟。
常见误区
“向量库越大越好”会拖慢检索;“换大模型能救召回”通常救不了;不备份原始文档,换模型就重来。
什么时候该迁移
查询 P95 持续上升、过滤越来越复杂、单机内存不够,就是迁移信号;别等数据量到千万才动手。
查询优化
topK 不要一次取太大,先召回 20 条再重排;过滤条件放前面,减少候选集,比调索引参数更有效。
和全文检索
向量检索不擅长精确匹配型号、订单号;混合关键词检索(BM25)能补上,别只靠 embedding。
选型清单
数据量、过滤、团队栈、备份、预算,五项打分;先跑一个月再定,别只看 benchmark。
德国节点
德国机房对欧盟用户近,合规解释成本低;带宽和机型不如美国丰富,提前确认库存。
数据迁移
迁移时保留原始文档和 chunk 映射,新库重建后抽样对比召回;别直接复制向量,模型和索引参数可能不兼容。
成本
内存和磁盘是大头,向量维度越高越吃内存;先量化到业务能接受的维度,再谈扩容。
先跑小规模,再按数据量扩容;向量库不是越大越好,够用最重要。
选型没有标准答案,只有和你的数据量、团队、预算匹配的答案。
先小规模验证召回,再谈性能和大规模。
召回和延迟,先保住召回,再优化延迟。
够用、能恢复、能迁移,就是好选型。
先把召回跑准,再谈别的。
召回准了,RAG 才成立。
先召回,再优化。
这样就好啊。
常见问题 FAQ
Q1:pgvector 能撑多少数据?
百万级以内比较稳,具体看维度、索引和内存;千万级建议 Qdrant/Milvus。
Q2:一定要独立的向量库吗?
不一定。已有 Postgres 就用 pgvector;要多租户过滤和高并发再独立。
Q3:美国还是德国节点?
欧盟数据放德国,成本和规模优先选美国;亚洲前台可以香港/日本。
Q4:换 Embedding 模型要重建吗?
要。维度或语义空间变了,旧向量不能直接用,必须重新 embedding。
Q5:怎么判断召回差是库的问题?
先看切分和 Embedding,再用同一批问题对比不同 topK;库通常不是第一嫌疑。
总结
RAG 向量库选型,先看数据量和过滤需求:小规模 pgvector,中等 Qdrant,大规模 Milvus。节点按用户和数据位置选,原始文档必须单独备份,换模型要重建索引。
需要一台机器跑向量库,想先验证,按小时开一台萤光云美国硅谷云服务器,先把索引和召回跑通。







