
 VPS知识分享站
Linode、Cloudflare、OpenAI 在同一周出故障,原因各不相同,但都指向一件事:计算、入口、数据全押一家,出事时没有退路。先问自己能不能切,再谈多云。
这周发生了什么
- 11 月 2 日:Linode 出现故障记录,UptimeRobot 有对应页面,具体范围和原因以其状态页为准
- 11 月 3 日:Cloudflare 亚太区域网络性能异常,12:44 调查、12:53 定位,部分线路掉包和 502
- 11 月 3 日:OpenAI 也有故障记录,API 用户可能遇到超时或 5xx
三件事没有证据表明是同一个原因,别硬串成“全球云崩了”。但它们发生在同一周,足够提醒你:外部依赖会同时抖动,而你的业务只有一个入口、一份数据、一台机器。
单云依赖的三个层面
| 层面 | 典型表现 | 逃生目标 |
|---|---|---|
| 计算 | 宿主机/区域故障,机器起不来 | 能快速重建或切到备节点 |
| 入口 | CDN、DNS、负载均衡故障,用户打不开 | 能切备用入口或回源 |
| 数据 | 数据库、对象存储不可用或损坏 | 有站外副本,能恢复、能迁走 |
多数团队只做了第一层(快照),入口和数据仍然是单点。真正出事时,快照能恢复机器,但用户还是打不开,数据还是搬不走。
方案一:备份能恢复
- 数据库每天全量 + binlog/WAL,备份传到另一家云或对象存储
- 文件、镜像、配置、证书、密钥一起备份,别只备数据
- 基础设施用脚本或 IaC 管理,新机器能按文档重建
- 每季度做一次恢复演练,记录 RTO 和失败点
“有备份”不等于“能恢复”。恢复演练没做过,真出事时大概率卡在版本、权限或证书上。
方案二:入口能切换
- DNS TTL 平时设低(60 到 300 秒),切换不用等
- 准备备用源站或第二 CDN,证书和回源 Host 提前对齐
- 静态资源做本地兜底或对象存储直出
- 把 Cloudflare 的 DNS only 作为临时验证手段,不要长期关代理
- 切换后先验证登录、支付、上传,再放全量流量
入口切换最怕“配置只存在某个人电脑里”。把 DNS、证书、回源、缓存规则写成 runbook,谁值班都能执行。
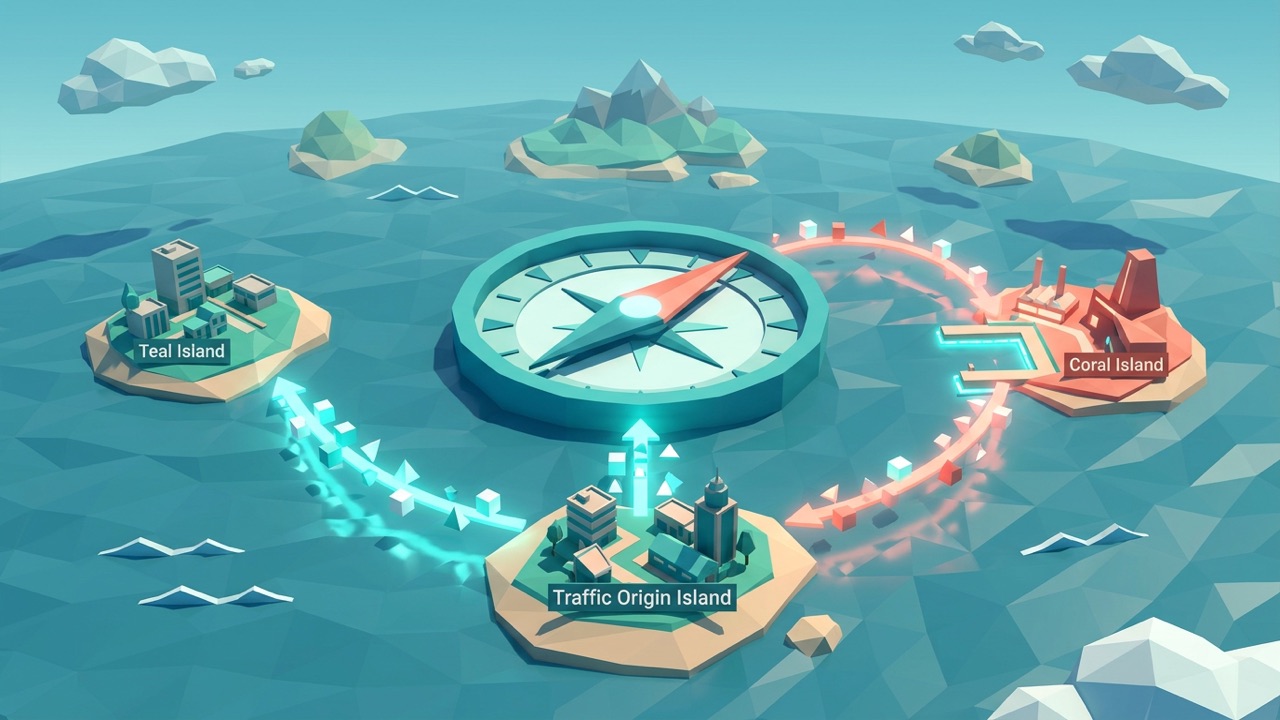
方案三:数据能搬走
- 数据库用标准 dump 或逻辑复制,别依赖厂商专有格式
- 对象存储用 S3 兼容接口,定期同步到另一处
- 镜像能导出,或至少有完整部署脚本
- 域名、证书、支付、短信等第三方依赖列清单,换云时逐项改
- 迁移前低 TTL、先同步、再切流量,旧环境保留一周
数据能搬走,才有议价权;搬不走,涨价和故障都只能接受。
成本怎么控制
双云不等于双份全量。常见做法是“核心热备 + 边缘冷备”:
- 数据库主库 + 异地只读/备份
- 入口主 CDN + 备用 DNS 切换
- 静态资源双云同步,应用镜像可重建
- 非核心业务单云,接受更长 RTO
按业务中断损失分配预算,别为所有服务做双活。
演练清单
- 停掉主入口,确认 DNS 能切到备用
- 停掉主库,确认从库/备份能恢复
- 删掉一台应用机,确认能按脚本重建
- 模拟对象存储不可用,确认静态资源有兜底
- 记录每一步耗时、失败点和负责人
为什么同一周
云服务、CDN、AI API 都是高度集中的基础设施,任何一家出问题都会影响大量用户。同一周发生不等于同源,但足以说明“外部依赖会同时抖动”。
RTO 和 RPO
先定目标:能停多久、能丢多少数据。RTO 是小时级,备份重建就够;RTO 是分钟级,才需要热备和自动切换。别用双活的成本做备份级的目标。
多 CDN
主 CDN 加备用 DNS/CDN,证书、缓存键、回源 Host 提前对齐;切换后先验证登录、支付、上传。多 CDN 会增加证书和缓存复杂度,按业务需要上。
演练频率
至少每季度一次,覆盖入口切换、数据库恢复、应用重建;大促前再加一次。演练不通过,方案就不算完成。
成本
双云不是双份全量。核心热备、边缘冷备、静态资源双云同步,按业务中断损失分配预算,比全部双活便宜得多。
常见误区
“有快照就不怕”“买了第二家云就高可用”“故障能索赔”都是误解;没有切换演练,第二家云只是多了一个账单。
先做哪件
先做恢复演练,再做低 TTL 和备用入口,最后才考虑多活。顺序反了,钱花了,故障时还是切不动。
DNS 细节
切换前把 TTL 调低并观察一天;切换后多地 dig 验证。别在故障当天才改 TTL,缓存还没过期,切了也没用。
数据细节
备份要加密、放站外、定期恢复;数据库 binlog/WAL 保留时间要覆盖最坏恢复窗口。数据搬不走,换云就是空话。
多云不等于高可用
两家云、两套环境,但流量切不过去、数据不同步,等于没有。高可用看切换能力,不看供应商数量。
监控
入口、源站、数据库、备份各设告警;故障时先看时间线,别同时改多个地方。
先修最弱的一环:备份不能恢复就练恢复,DNS 切不动就调 TTL,数据搬不走就做导出。别同时上三个方案。
能切、能恢复、能搬走,比“买了几家云”更重要。
别等下一次故障,才想起演练。
平时多演练,故障时少慌乱。
能切,才算真的有退路,真的。
常见问题 FAQ
Q1:这周故障是同一个原因吗?
没有证据表明是同一原因。Linode、Cloudflare、OpenAI 是不同层面的服务,别混为一谈。
Q2:小团队需要多云吗?
不一定全量多云。先做到“备份能恢复、入口能切、数据能搬”,比买第二套集群更实际。
Q3:双活是不是更安全?
双活复杂度高,数据冲突和成本都翻倍;多数业务温备 + 快速切换就够。
Q4:云厂商故障能索赔吗?
看合同 SLA,通常按可用性赔付,金额有限;别把业务连续性寄托在赔付上。
Q5:先做哪一件?
先做恢复演练。备份不能恢复,后面所有方案都是空的。
总结
单云依赖的解法不是“再买一家”,而是三层逃生:备份能恢复、入口能切换、数据能搬走。先做恢复演练和低 TTL,再考虑温备和多云;成本按业务中断损失分配。
要做切换和恢复演练,先按小时开一台香港 CN2 云主机当备用源站,流程跑通再谈多云。







