VPS知识分享站
RabbitMQ 和 Kafka 都能传消息,但脾气不一样。任务队列、路由灵活选 RabbitMQ;日志和事件流、高吞吐选 Kafka。选错不是不能跑,是磁盘和运维成本会教你做人。
先分清场景:
- 任务队列:下单、发邮件、转码,要求可靠、重试
- 事件流:日志、埋点、CDC,要求高吞吐、可回放
- 延迟队列:定时任务、超时取消
- 广播:多消费者各自处理
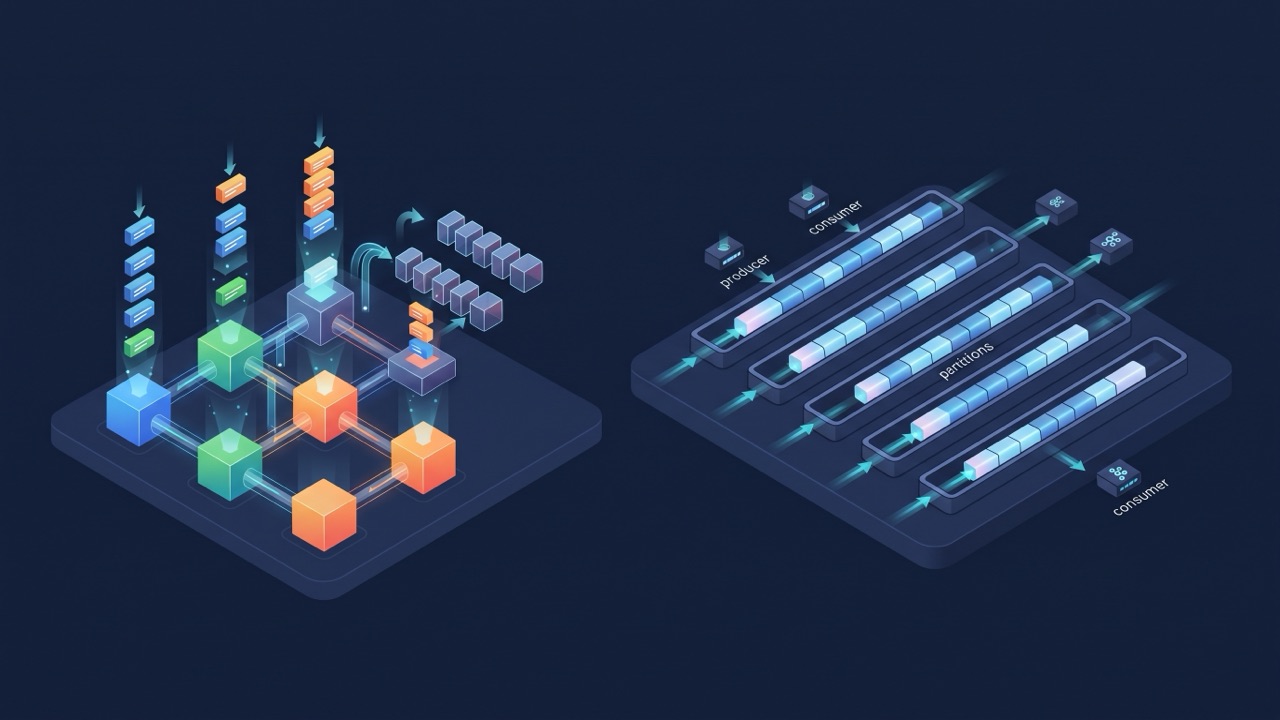
RabbitMQ 和 Kafka
| 维度 | RabbitMQ | Kafka |
|---|---|---|
| 模型 | 队列/交换器 | 分区日志 |
| 吞吐 | 中 | 高 |
| 顺序 | 队列内 | 分区内 |
| 回放 | 弱 | 强 |
| 运维 | 简单 | 较复杂 |
| 适合 | 任务、RPC | 日志、事件流 |
配置怎么选
- RabbitMQ:2 核 4G 起,内存看队列积压,磁盘持久化
- Kafka:4 核 8G 起,磁盘要大、IOPS 要高,JVM 堆别太大
- 生产:至少 3 节点,副本 2 到 3
- 磁盘:独立数据盘,留 30% 余量
磁盘怎么规划
消息队列是“写多读多”的服务,磁盘 IOPS 和吞吐比 CPU 重要。Kafka 顺序写也要足够带宽;RabbitMQ 持久化消息会刷盘。保留时间、日志段大小、清理策略要设上限。
部署
# RabbitMQ
docker run -d --name rabbitmq -p 5672:5672 -p 15672:15672 rabbitmq:3-management

# Kafka(KRaft 单节点示例)
docker run -d --name kafka -p 9092:9092 apache/kafka:latest
生产别用单节点;RabbitMQ 用镜像队列/Quorum Queue,Kafka 用多 broker + 副本。
可靠性
- 生产者确认(publisher confirm / acks)
- 消费者手动 ack,处理成功再确认
- 持久化 + 副本,别只靠内存
- 死信队列/重试队列,处理失败消息
- 幂等消费,防重复
监控
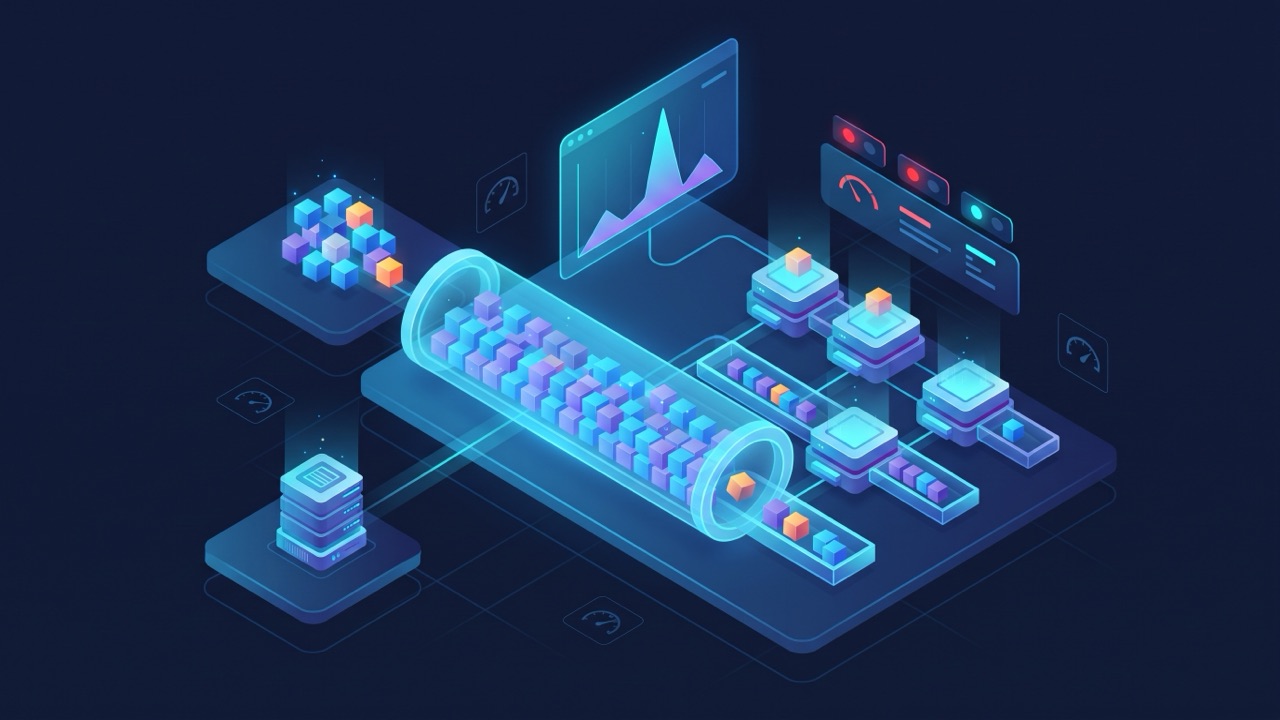
RabbitMQ 看队列长度、未确认消息、消费者数、磁盘;Kafka 看消费 lag、分区、副本同步、磁盘。lag 持续增长说明消费跟不上。
常见坑
- 单节点当生产,挂了消息全丢
- 队列无限积压,磁盘满
- 自动 ack,处理失败也丢消息
- Kafka 分区数不合理,消费上不去
- JVM 堆太大,GC 停顿
- 没设保留时间,磁盘被日志吃满
RabbitMQ 配置
看队列长度、消费者数、内存水位;持久化消息会刷盘,磁盘 IOPS 要够。镜像队列/Quorum Queue 提供副本,但会增加网络和磁盘开销。
Kafka 配置
分区数决定并行度,副本数决定可靠性;JVM 堆别超过物理内存一半,页缓存留给日志读写。磁盘顺序写吞吐高,但容量要大。
分区怎么定
按消费者并行度和峰值吞吐定,分区太多增加元数据和 rebalance 成本;一般从 6 到 12 个分区起步,按压测调。
持久化和保留
RabbitMQ 持久化队列 + 消息,Kafka 副本 + 保留时间;保留时间按业务和磁盘算,别无限保留。
消费
手动 ack、幂等处理、失败进死信/重试;消费慢先加消费者或分区,别盲目加机器。
高可用
生产至少 3 节点,副本 2 到 3;跨可用区部署,避免单区故障;监控副本同步和选主。
成本
消息队列成本主要是磁盘和带宽;按“吞吐 × 保留时间 × 副本”算,比只看实例费准。
延迟队列
RabbitMQ 用 TTL + 死信实现延迟,Kafka 不擅长延迟;定时任务也可以直接用数据库/调度器,别硬套消息队列。
消息顺序
RabbitMQ 单队列有序,多消费者会乱;Kafka 只保证分区内有序,按业务键选分区。需要全局顺序时,单分区会限制吞吐。
安全
开鉴权、TLS、限制来源;管理端口别暴露公网,默认账号必须改。消息里可能有敏感数据,注意加密和权限。
压测
压生产/消费吞吐、延迟和积压恢复;观察磁盘、网络和 GC。压测通过再上线,别拿生产试。
运维
升级、扩分区、加副本都要有预案;配置和 topic 变更记录在案,别让集群状态只存在某个人脑子里。
选型建议
任务队列、路由复杂用 RabbitMQ;日志/事件流、高吞吐、要回放用 Kafka;小项目先用 Redis 队列也行。
常见误区
“消息队列一定可靠”忽略 ack 和副本;“Kafka 一定快”忽略磁盘和分区;“上队列就解耦”忽略幂等和顺序。
云盘
Kafka/RabbitMQ 都怕磁盘延迟,选高 IOPS 云盘或本地 SSD;网络盘抖动会拖慢生产和消费,压测时重点看 await。
监控告警
队列长度、lag、磁盘、副本同步、GC 都要告警;lag 持续增长先查消费者,再查生产突增。
备份
队列配置、topic、ACL 定期导出;消息本身通常不备份,靠副本和重放,重要业务要落库。
最后
先想清消息丢了能不能重放、重复能不能幂等,再选型和配置。
消息队列是基础设施,稳定性和可观测性比功能多更重要。
配置、副本、监控、幂等四件事做好,消息队列才可靠。
先跑通生产消费,再压测积压恢复,最后上生产。
队列不是越复杂越好,够用、可靠、能监控就行。
稳定性优先,功能其次,真的,别怀疑,这一点真的没错啊啊!!!!
常见问题 FAQ
Q1:小项目需要 Kafka 吗?
不一定。任务队列用 RabbitMQ/Redis 就够;要高吞吐事件流和回放再上 Kafka。
Q2:2 核 4G 能跑 RabbitMQ 吗?
能跑小规模,队列积压和持久化会吃内存/磁盘;生产建议 4 核 8G 起。
Q3:消息丢了怎么办?
查生产确认、持久化、副本、ack 模式;先保证不丢,再谈重试和死信。
Q4:Kafka 磁盘要多大?
按吞吐 × 保留时间 × 副本数估算,留 30% 余量;日志/事件流往往比业务库大。
Q5:需要独立服务器吗?
消息量大、可靠性要求高时独立;小项目可以和应用同机,但磁盘和内存要留足。
总结
RabbitMQ 做任务队列,Kafka 做高吞吐事件流;配置看内存和磁盘,生产多节点 + 副本,监控积压和 lag,设保留上限,做好幂等和死信。
想跑单节点队列测试,先按小时开一台香港 CN2 云主机,跑通再扩集群。