 VPS知识分享站
先说结论:只接模型 API、做轻量任务编排,2 核 4G 够用;要跑浏览器自动化、截图、并发任务,4 核 8G 起步;要多租户、多并发、长任务队列,再往上加。AI Agent 吃紧的通常不是 CPU,而是内存、磁盘和网络稳定性。
选服务器前先分清你的 Agent 属于哪一种:
- API 后端型:只做鉴权、限流、调模型、存结果,最轻
- 浏览器自动化型:Playwright/Puppeteer 开浏览器、点页面、截图,最吃内存
- 队列任务型:批量跑长任务,吃 CPU 和磁盘,怕任务堆积
下面按“三种形态 → 资源估算 → 配置表 → 浏览器自动化 → 队列 → 网络 → 成本”讲,最后给一份上线检查清单。
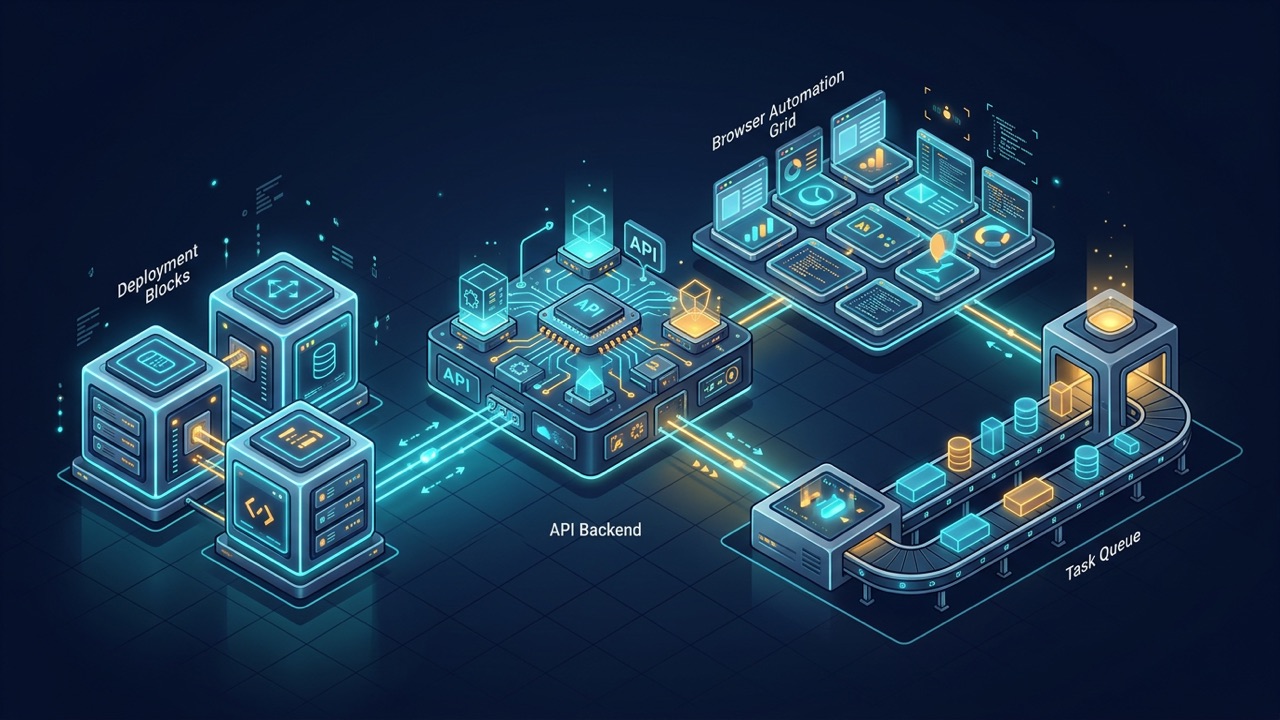
三种部署形态
API 后端型:用户请求进来,后端做鉴权、拼提示词、调模型、把结果写回数据库。服务是无状态的,可以水平扩,单机 2 核 4G 能撑不少并发。
浏览器自动化型:Agent 要打开网页、填表单、点按钮、截图。每个 Chromium 实例通常占 200 到 500MB 内存,页面复杂时更高;并发一上来,内存比 CPU 先爆。
队列任务型:任务进队列,worker 慢慢消费。CPU 占用高、单任务时间长,重点是并发控制、重试和幂等,不是机器核数。
资源怎么估
- CPU:API 后端 2 核够;浏览器自动化 4 核起;视频/图片处理再加
- 内存:系统 0.5G + 应用 0.5G + 每个浏览器 0.3-0.5G × 并发数 + 余量
- 磁盘:截图、日志、缓存、模型文件;80G 起步,跑久了上对象存储
- 带宽:API 调用流量小,截图和文件上传下载才是大头
一个实用的估算法:先按 2 个并发浏览器、每实例 0.5G 算,4G 内存只够跑 2 到 3 个;要跑 4 个以上,直接上 8G。
配置表
| 场景 | 建议配置 | 说明 |
|---|---|---|
| API 后端、轻量编排 | 2 核 4G,80G SSD | 无状态,可水平扩 |
| 浏览器自动化,2-4 并发 | 4 核 8G,160G SSD | 内存优先,注意 /dev/shm |
| 多租户、长任务队列 | 8 核 16G 起 | 按 worker 数和任务时长算 |
| 本地小模型/推理 | 看模型,另算 GPU | 不在本文范围 |
浏览器自动化怎么配
浏览器自动化是最容易踩坑的部分。几个关键点:
- 共享内存:Chromium 默认用
/dev/shm,容器里通常只有 64MB,页面一复杂就崩。启动时加--shm-size=1g或--ipc=host。 - 并发上限:不要按 CPU 核数开并发,按内存算。每个实例留 0.5G,4G 机器最多 2 到 3 个。
- 超时和回收:每个任务设硬超时,浏览器实例用完就关,别复用太久,内存泄漏会累积。
- 无头模式:生产用 headless,调试再开有头;截图和 PDF 输出注意磁盘清理。
# 示例:给 Playwright 容器足够的共享内存
docker run --rm \
  --shm-size=1g \
  --memory=2g \
  --cpus=2 \
  mcr.microsoft.com/playwright:latest \
  node agent.js
队列和并发
Agent 任务通常比普通请求长,必须走队列:
- API 只负责入队,立即返回任务 ID
- Worker 从队列取任务,按机器能力设并发
- 每个任务有超时、重试上限和幂等键
- 失败任务进死信队列,人工排查
- 任务状态和结果落库,前端轮询或推送
队列可以用 Redis、Postgres 或云队列。小规模用 Redis 就够,别一上来上 Kafka。
网络和 IP
Agent 调用的模型 API 大多在海外,服务器放美国,延迟和稳定性通常更好。如果 Agent 还要登录海外平台、跑电商后台或社媒任务,固定、干净、归属地正确的 IP 很重要。
面向美国业务,推荐萤光云美国硅谷云服务器:硅谷机房、原生美国 IP,IP 归属地址显示正确、DNS 解析无误,KVM 独享、免备案,适合 AI 工具后端、浏览器自动化和出海业务。API 后端 2 核 4G 起步,跑浏览器自动化建议 4 核 8G。
存储和日志
Agent 会产生大量截图、HTML、PDF、日志。建议:
- 截图和产物放对象存储,服务器只留最近 3 到 7 天
- 日志按天切割,保留 7 到 30 天,敏感字段脱敏
- 数据库只存任务状态、结果摘要和计费数据
- 定期清理临时目录,避免磁盘被截图撑满
成本怎么算
Agent 的成本 = 服务器 + 模型 API + 存储/带宽 + 人工。很多人只算 API,忽略了浏览器自动化的机器成本和重试带来的额外调用。省钱的顺序是:先优化提示词和任务轮次,再上缓存,最后才考虑换更便宜的模型或机器。
上线检查清单
- API Key 只在服务端,能轮换
- 按用户/租户限流,设置任务超时和重试上限
- 浏览器容器有 shm 配置和内存上限
- 队列有死信和告警,任务幂等
- 磁盘和水位告警,截图定期清理
- 服务器快照和备份可用
- 安全组只开必要端口,SSH 密钥登录
- 用真实任务压测 24 小时,记录并发、内存和成本
常见问题 FAQ
Q1:2 核 4G 能跑 AI Agent 吗?
能跑 API 后端和轻量任务编排。要开浏览器、跑并发,4G 内存不够,建议 4 核 8G。
Q2:为什么浏览器一开就崩?
多半是 /dev/shm 太小或内存不足。加 --shm-size=1g,限制并发,给容器设内存上限。
Q3:Agent 一定要用美国服务器吗?
不一定,但模型 API 和海外平台大多在美国,放美国延迟更低、IP 更稳定。用户主要在国内的,可以选香港或日本节点做接入。
Q4:需要 GPU 吗?
调 API 不需要。只有跑本地模型、图片生成或视频处理才需要 GPU,普通 Agent 用 CPU 机器就够。
Q5:一台机器能跑多少个 Agent?
看任务类型。API 型按 QPS 算,浏览器型按内存算(每实例 0.5G 左右),队列型按 worker 数和任务时长算。
参考来源
总结
AI Agent 选服务器,先看形态:API 后端 2 核 4G 够,浏览器自动化 4 核 8G 起,长任务队列按 worker 数加。内存、shm、磁盘和网络比 CPU 更容易成为瓶颈。先按真实任务压测 24 小时,再决定长期配置。
需要一台美国节点跑 Agent 后端和浏览器自动化,可以从萤光云美国硅谷云服务器按小时开一台,原生美国 IP,验证完再转长期。