 VPS知识分享站
先说结论:Gemini 4 Argon 在 2026 年 10 月 14 日发布,最值得关注的变化不是跑分,而是 100 万 token 的统一上下文,以及一轮到 11 月 30 日的 API 半价。个人用户要不要换,取决于你现在用 Gemini 做什么;开发者要不要接,先把缓存命中率和输出长度算清楚,再决定。
如果你只是想知道“这个东西怎么打开、要不要付费”,可以直接看下面的入口清单:
- 在 App 或搜索里用:先确认订阅档位和所在地区,Pro 和 Ultra 能看到的入口不一样
- 试提示词、拿 API Key:Google AI Studio 最快,适合原型验证
- 接进自己的产品:Gemini API 或 Vertex AI,密钥只能放服务端
- 评估成本:按输入、输出、缓存命中三块算,别只盯每百万 token 的单价
这篇把入口、订阅、API、费用和上线检查拆开讲。功能和价格变化很快,文中的数字以 2026 年 10 月 23 日公开信息为准,实际以官方页面为准。
Gemini 4 Argon 这次变了什么
Argon 是这一代 Gemini 4 的旗舰型号。Google 公布的三组变化,对实际使用影响最大:
- 统一上下文 100 万 token:输入、思考、输出共享这一份额度,不再像过去那样把输入和输出分开算。配合 Long Decode,单次任务的累计输出可以突破传统的 64K 限制,但实际能输出多少,仍取决于输入占用了多少额度。
- 长流程任务:Google 把它定位成能连续处理编程、金融、法律、网络安全和科研任务的模型,而不是只做一问一答。
- Agent 场景:Google 公布的内部数据里,使用 Argon 和 Antigravity 的团队,Agent 生成的代码提交量增加超过 35%,回滚量减少近三分之一。
评测方面,Google 公布的 Vals Index 成绩是 68.9%,DeepSWE v1.1 是 77.9%,CWE-bench v1 是 68%。这些数字可以参考,但别当成选型依据:厂商公布的评测用的是特定任务集,和你的业务样本不是一回事。真正要做的,是拿 100 到 500 条自己的脱敏样本跑一遍。
还有一个容易被忽略的点:Gemini 4 不等于所有入口都立刻用上 Argon。App、搜索 AI Mode、AI Studio、API、Vertex AI、Antigravity 的上线节奏和可用档位不一样,同一个账号在不同入口看到的能力也可能不同。遇到“别人有我没有”,先查对应入口的官方说明,不要默认是账号坏了。
四个官方入口怎么选
| 入口 | 适合谁 | 关键注意点 |
|---|---|---|
| Gemini App / 搜索 AI Mode | 个人对话、写作、文件分析 | 需要 Pro 或 Ultra 档位;地区和账号要求以官方为准 |
| Google AI Studio | 试提示词、对比模型、生成起步代码 | 免费额度有限;密钥只能放服务端 |
| Gemini API | 接入自有产品、批量任务 | 按 token 计费,必须自己做限流、日志和预算 |
| Vertex AI | 企业生产环境 | 区域、IAM、审计和账单体系更完整,配置也更重 |
| Antigravity | 智能体编程 | 面向 Ultra 订阅开放,具体入口以官方为准 |
这五个入口不是“哪个高级用哪个”,而是四件不同的事:App 是消费级产品,AI Studio 是试验台,API 是积木,Vertex AI 是企业生产线,Antigravity 是给 Agent 用的编程环境。选错入口最常见的后果,是拿消费级订阅去接生产流量,或者拿 API 直接暴露在前端。
另外,入口不同,数据政策也不同。消费级 App 的数据可能用于改进服务,企业级 Vertex AI 的条款、区域和审计能力完全另一套。把客户数据从企业入口搬到个人账号,是很多团队踩过的坑。
个人用户怎么用
个人使用路径不复杂,难的是确认自己到底能用哪一档:
- 打开 Gemini 官方网页或官方 App,用 Google 账号登录
- 确认账号类型、年龄和所在地区是否符合当前要求
- 看订阅档位:Pro 和 Ultra 能用的模型、上下文和功能不一样,先在官方订阅页核对价格、试用期、续费和取消方式
- 先用不含敏感信息的任务测试,比如整理公开资料、生成提纲、改写一段文案
- 上传文件前检查内容,别把合同、客户名单、密钥和身份证件传进去
搜索里的 AI Mode 是另一个入口,适合“边搜边问”的场景。它的可用范围同样受地区和账号限制,和 App 不是一回事。你在网页上能看到,不代表手机 App、Workspace 或 API 也能看到。
如果账号里找不到某个功能,先查三件事:地区是否在支持列表、账号是不是 Workspace 或学校账号、管理员有没有关掉对应开关。不要为了一个功能去注册一堆账号,数据和订阅都会变得很难管。
开发者怎么接 API
原型阶段用 AI Studio 最省事:建项目、生成 API Key、在浏览器里调提示词,确认效果后复制起步代码。真正的生产接入,建议按下面的顺序做:
- 在 AI Studio 的模型列表里确认当前可用的 Gemini 4 型号,把模型 ID 复制到配置里,不要硬编码在业务代码中
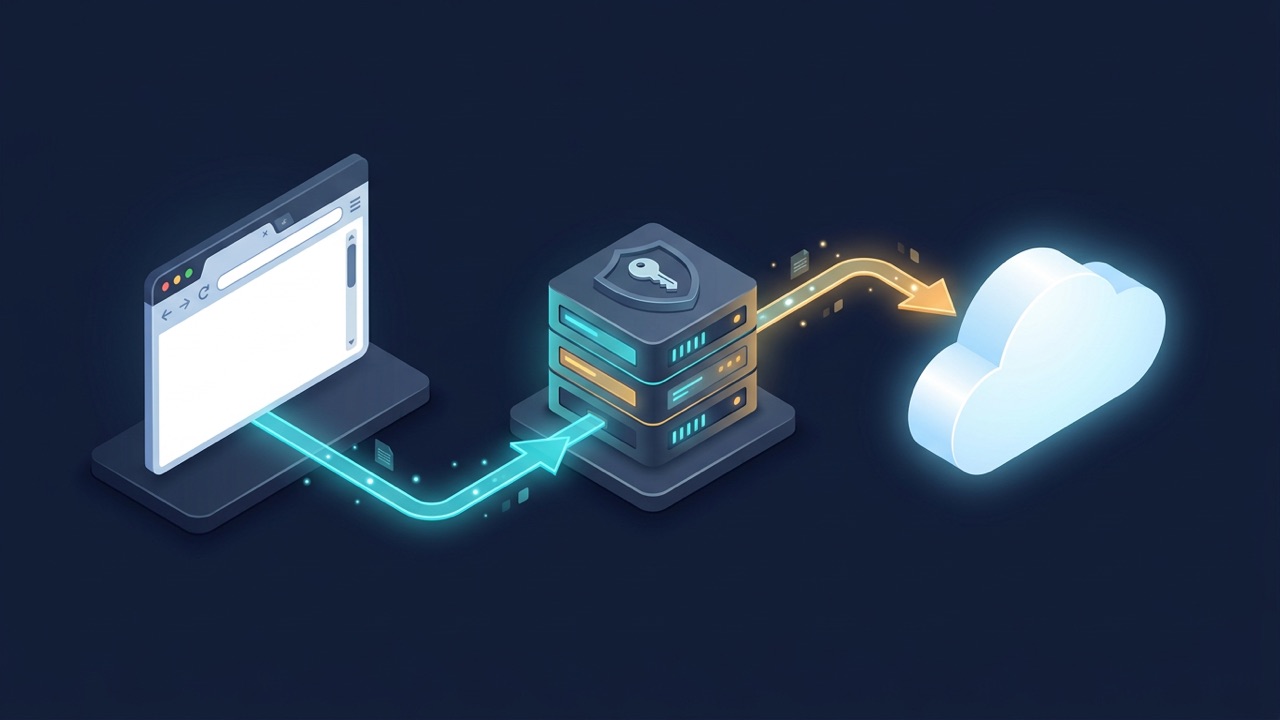
- API Key 放服务端环境变量或密钥管理服务,前端、客户端安装包、公开仓库里都不能出现
- 给每个用户或租户做限流,给每次请求设超时,重试要带退避和次数上限
- 记录调用量、延迟、错误率和成本,日志里不要留完整提示词和敏感数据
- 准备一个降级模型或备用供应商,主模型超时或限流时能切换
import os
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

resp = client.models.generate_content(
    model=os.environ["GEMINI_MODEL_ID"],  # 从 AI Studio 模型列表复制
    contents="把这段客服对话整理成三条待办,只输出 JSON。",
)
print(resp.text)
模型 ID 会随版本变化,代码里用环境变量是最省心的做法。另一个常见错误是把密钥写进前端 JavaScript,觉得“反正有域名限制”。公开前端里的密钥等于公开,任何人复制走都能刷你的账单。
1M 上下文怎么用才不烧钱
100 万 token 的上下文很诱人,但它不是免费的内存。上下文越长,输入 token 越多,单次请求越贵、越慢,而且模型不一定能把每个角落都用到。比较务实的用法有三种:
- 长文档问答:合同、财报、技术手册,一次放进去,问具体问题。适合低频、高价值的任务,不适合每个用户请求都塞一遍。
- 代码库分析:把相关模块和接口定义一起给模型,而不是把整个仓库倒进去。先做检索,再拼上下文。
- 缓存复用:系统提示、固定知识库、长说明书这类重复内容,走上下文缓存。官方这轮给到 95% 的缓存折扣,命中率高的业务,账单差别很大。
反过来,三种用法要避免:把整个知识库每次全量塞进去、把长上下文当数据库用、让模型在超长上下文里做精确计数。这些场景要么贵,要么不稳定,不如先做检索和结构化。
API 费用怎么算
按公开报道,2026 年 11 月 30 日之前,Gemini 4 Argon 的 API 价格是每百万输入 token 2 美元、每百万输出 token 10 美元;11 月底之后价格会翻倍。同期上下文缓存有 95% 的折扣。具体价格、缓存存储费和最低计费单位,以官方定价页为准。
拿一个具体例子算:每天 1,000 次请求,每次输入 8,000 token、输出 1,000 token。
- 输入:1,000 × 8,000 = 800 万 token/天,按 2 美元/百万算,16 美元/天
- 输出:1,000 × 1,000 = 100 万 token/天,按 10 美元/百万算,10 美元/天
- 合计:26 美元/天,按 30 天算约 780 美元/月
- 优惠结束后翻倍:约 52 美元/天,1,560 美元/月
如果其中 80% 的输入命中缓存,按 95% 折扣算:缓存部分 640 万 token 只要 0.64 美元,未缓存部分 160 万 token 是 3.2 美元,输入合计 3.84 美元;加上输出 10 美元,每天约 13.84 美元,一个月约 415 美元。缓存不是自动生效的,需要按官方要求组织请求和缓存内容。
这张账还有几项没算进去:重试、失败请求、日志和存储、你自己的服务器、人工审核。做预算时别只按“单价 × 请求数”,要按“每次成功完成业务任务的成本”算。
国内和出海团队怎么合规使用
Gemini 4 的网页应用、订阅和 API 按 Google 官方支持地区提供。中国大陆不在官方支持地区,账号、付款和网络可用性都可能受限。这不是靠一台服务器就能解决的问题。
企业出海团队常见的合规路径是:用海外主体签约、按合同约定处理数据、确认用户数据跨境的合法性、在隐私政策里说明使用的模型和数据处理方式。如果业务面向欧盟用户,还要看数据出境和 AI 相关的合规要求。
需要明确一点:不要用 VPS、代理或其他方式绕过地区限制。这类做法违反服务条款,账号随时可能被停,数据也拿不回来;对公业务更不该把稳定性建立在灰色手段上。VPS 的正确用途,是部署你自己的后端、队列、缓存和管理后台,而不是伪装访问地区。
上线前的 8 项检查
- 前端源码和网络请求里找不到 API Key
- 未登录、越权、超量请求会被后端拒绝
- 模型超时或报错时,用户看到明确提示,不会无限重试
- 单用户限额、项目预算和异常调用告警能触发
- 日志不记录完整密钥、合同、客户对话和身份证件
- 输出经过格式和安全校验,不直接把模型返回丢给前端渲染
- 有降级模型或备用供应商,主模型不可用时能切换
- 用目标用户所在地区的网络做一次端到端测试
什么时候需要一台 VPS
只用 Gemini App 或网页,不需要服务器。需要服务器的场景很具体:你要跑自己的 API 后端、做鉴权、限流、缓存、队列、日志、成本统计,或者要给团队一个统一的管理后台。
这类后端不重。原型阶段 1 核 2G 就能跑;有并发和缓存需求再往上加。选节点看你的用户在哪:面向美国用户或需要较低延迟访问海外 API 的,可以看萤光云美国 VPS;面向东南亚用户的,日本或新加坡节点更合适。
部署时先把安全组、SSH 密钥、备份和监控做好,再接模型 API。具体配置可以参考站内的Docker 应用需要多大 VPS,安全检查按新服务器上线前的 12 项检查走一遍。
常见问题 FAQ
Q1:Gemini 4 免费用吗?
App 和网页通常有免费额度,但 Gemini 4 Argon 这类旗舰模型往往优先给 Pro、Ultra 或特定入口。API 是按 token 付费的,不存在无限免费。具体额度以官方页面为准。
Q2:怎么知道我的账号有没有 Argon?
看对应入口的模型列表或档位说明。App、AI Studio、API 的可用范围不一样,不要拿一个入口的判断去推断另一个。
Q3:App 里用的和 API 调用的是同一个模型吗?
不一定。消费级产品会按档位、地区和负载选择模型,API 则是你显式指定型号。要可复现的结果,用 API 并固定模型版本。
Q4:100 万上下文能一次放一整本书吗?
技术上要看 token 和文件限制,成本上也要看。一次放进去很贵,而且模型对超长内容的细节召回并不稳定。更稳的做法是先检索、再分段提问。
Q5:11 月 30 日之后价格会涨吗?
按目前公开报道,优惠结束后价格会翻倍。做 Q4 预算时按原价算,别按促销价签长期合同。最终以官方定价页为准。
Q6:用 VPS 能绕过地区限制吗?
不建议,也不能保证有效。应遵守 Google 当前的地区、账号、付款和服务条款;VPS 只用于部署你有权运行的自有应用。
Q7:Gemini 4、GPT-6 Astra、Claude Opus 5.5 怎么选?
别只看榜单。用同一批业务样本,比较成功率、延迟、单次任务成本和失败时的可恢复性。模型迭代很快,选型结论最好每季度复核一次。
参考来源
- 36氪:Gemini 4 发布、定价与评测信息(2026-10-14)
- Google Cloud:Gemini 4 Argon available on Google Cloud
- Google AI for Developers:Gemini API 文档
总结
Gemini 4 Argon 的核心卖点是长上下文和长流程任务,加上一轮有时限的 API 折扣。个人用户先确认档位和地区,开发者先算缓存和输出成本,企业先解决合规和数据问题。把它当成一个能力更强、但计费更细的工具,而不是“免费升级”。
需要一台干净的后端机器接 API、跑队列和缓存,可以从萤光云美国 VPS 按小时开一台测试,验证完再决定长期配置。